第四章:让数据篡改变困难
为了保证用户的密码永远不会被泄漏,Q公司提供了密钥登录模式。为了方便审计公司查账,也为了证明自己不会随意修改用户的Q币余额,Q公司又进一步把记账模式从账户模型改成了UTXO模型。但是我们也知道,仅仅切换到UTXO模型只解决了篡改交易的问题。Q公司还是可以随意增发Q币,删除用户的交易,或者拒绝记录某些交易。这些问题既困扰着Q公司,也让用户担忧。
但Q公司前进的决心是坚定的。经过一番研究,Q公司发现有一种技术,恰好可以解决目前的困境。而且巧的是,现在的UTXO模型刚好和这种技术不谋而合。这个技术还有一个很酷的名字,那就是大名鼎鼎的——区块链。本章我们继续跟随Q公司的步伐,看看它是怎么把区块链技术落地的。
交易格式
为了用上区块链技术,我们需要把前一章设计的交易表重构一下。还记得吗?交易表的每一行是一条交易记录,一条或者连续几条交易记录构成一笔完整的转账交易。现在,我们把构成一笔交易的记录都打包在一起,形成一个整体,然后统一签名。很自然地,我们把这个新的数据叫做交易数据。在没有歧义的情况下,我们也直接把它简称为交易。新的交易数据格式如下图所示:
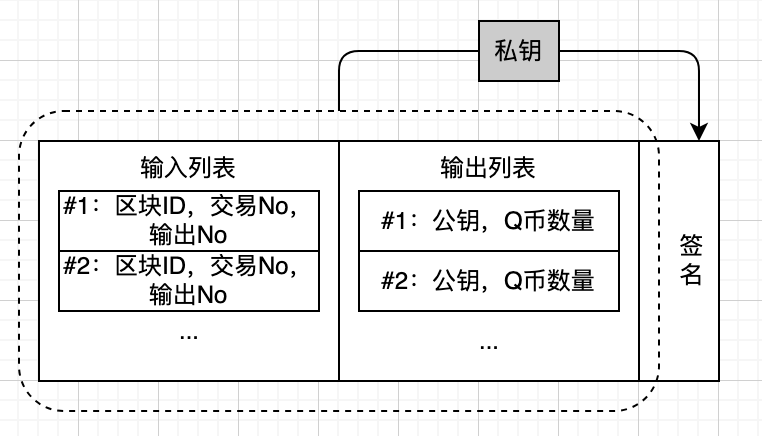
如果你还记得老的交易表,新的交易格式从结构上看还是比较好理解的。我们基本上就是把同一笔交易的记录做了一个压缩,去掉了冗余信息。假设某笔交易原来由N个记录构成,那么:第一,原来输入列表需要复制N份,现在只要一份就够了;第二,原来每一个记录有一个输出,现在这些输出被合并成了列表;第三,原来每一个记录都要单独签名,现在对整个交易进行签名。
但是输入列表的内部细节变了,原来是记录ID的列表,现在变成了“区块ID+交易编号+输出编号”的列表。这是怎么回事?那我们必须先看一下什么是区块,以及区块的格式,然后这个问题就迎刃而解了。
区块格式
从概念上讲,我们把N个交易放在一起,再打成一个包,这就是所谓的区块(Block)。但实际上会略微复杂一些,因为区块里还需要放一些额外信息。假设说某个区块包含了四笔交易,它的内容和格式如下图所示:
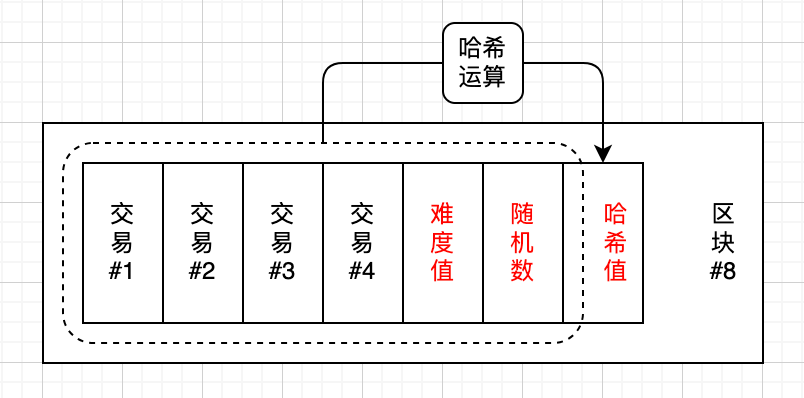
我们先来看一些比较明显的内容。第一,每个区块都有一个唯一ID,从1开始递增,比如上图这个区块的ID是8。前面讲到的交易输入列表里的区块ID指的就是这个ID。第二,区块里的交易按顺序排列,每笔交易都有一个编号,从1开始递增。交易输入列表里的交易编号指的就是这个编号。通过区块ID+交易编号,就可以在整条链上唯一锁定一笔交易了。那么输入列表里的第三项,也就是输出编号呢?它指的是这笔交易的输出列表里的第几个输出。毕竟一笔交易可能产生好几个输出,而我们这次要花掉的只是其中一个。三个编号合在一起,才精确指向了一个UTXO。
哈希值相对也是好理解的。把所有的交易数据(以及少量额外数据和一个随机数)一起通过哈希运算得到一个哈希值,它可以当作整个区块的指纹。区块里的任何交易(包括这个随机数)只要有一点点的变化,这个指纹也会跟着变化。那么为什么要加上这个哈希值呢?难度值和随机数又是用来干啥的?先不着急,下下一节会解释清楚。我们先通过例子来加深一下对于新的交易和区块格式的理解。
交易解析
在前一章的“转账交易”这一小节里,我们通过四个具体的例子仔细分析了交易记录表。这一节我们用同样的例子再把新交易和区块格式也解释一遍,看懂这几个例子,区块的概念也就具象化了。为了便于描述,我们假设每一个区块里都只有一笔交易。四笔交易,四个区块,从左到右如下图所示:
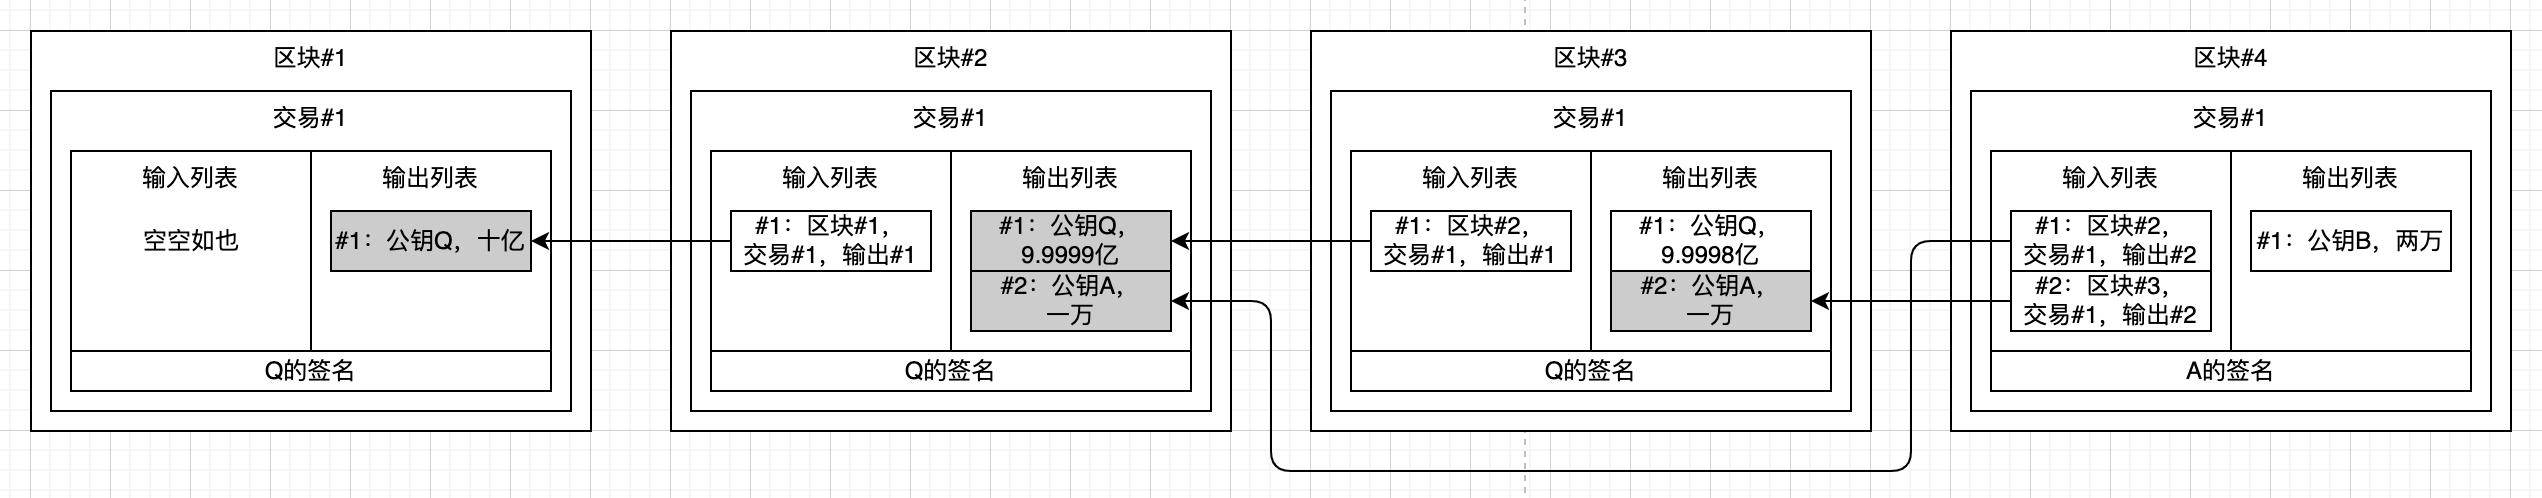
第一笔交易,Q公司铸造十亿枚Q币。这是一笔特殊的交易,因为它没有输入。目前的规则是只有Q公司可以签署这样的交易,而且整个系统中只能有一笔(也就是第一笔)这样的交易。但是Q公司可能会不守承诺,这个问题我们后面解决。
第二笔交易,用户A购买一万枚Q币。这笔交易只有一个输入,就是前面那笔铸币交易的输出。产生两个新的输出,第一个是找零,让剩余的Q币回到Q公司。第二个是付款,把一万枚Q币转给A用户。某一个输出,只能被当作输入使用一次。
第三笔交易,用户A又购买一万枚Q币。这笔交易和第二笔交易基本上是一样的。我们用灰色表示已经被花掉的输出,白色表示还没被花掉的输出,也就是UTXO。所有的UTXO表示的金额加起来等于总发行量,某个公钥对应的UTXO加起来等于这个账户的Q币余额。
第四笔交易,用户A转给用户B两万枚Q币。这笔交易有两个输入(花掉两个输出),但是只产生了一个新的输出。注意看交易是用户A签署的,他只能花属于自己的输出。前面两笔交易模拟了现实生活中的“找零”行为,这笔交易则是模拟了现实生活中的“凑零钱付款”行为。
工作证明
好,现在我们可以来解释区块里的随机数和哈希值是起啥作用的了。前面说过,虽然Q公司无法篡改和伪造用户的交易了,但是可以轻松删除用户的交易。为了自证清白,Q公司决定提高自己删除交易的难度。具体是怎么做到的呢?它给区块增加了一条新的规则:所有的区块哈希值(共256比特),如果用二进制表示的话,前面的N(比如8)个比特必须是0,如下图所示:
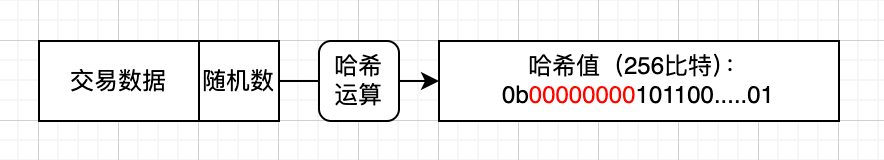
我们知道,密码学安全的哈希函数产生的哈希值看起来就像随机数,毫无规律,而且你也没有办法操纵这个值。那么怎么才能得到前面有这么多个零的哈希值呢?在不改变交易核心数据的情况下,Q公司只能不停地调整这个随机数(比如从零开始递增),然后重新计算哈希值,直到它满足要求为止。换句话说,想要得到符合要求的区块哈希值,没有捷径,只能靠运气不停地尝试。但是反过来,一旦这个随机数确定,任何人都可以很轻易地验证它(只要用区块数据算一次哈希值就可以了)。
想象一下,你有一大把的硬币(一共256枚),每一枚都按顺序编好了号(从1一直排到256)。你可以把它们一次性抛向空中,等所有硬币落地后,只要前8枚恰好全部正面朝上,就能获得奖励。你没有任何能操控结果的办法,全靠纯粹的运气。但是检查结果很容易,看一眼地上的硬币就行。那么问题来了:你大概需要抛多少次,才能碰巧遇到前8枚硬币都正面朝上的情况?答案是约256(
也就是说,为了产生一个合格的区块,Q公司必须要做大量的计算。而且一旦删掉一笔交易,整个区块数据就变了,就必须重新计算哈希值使其满足要求。好吧,Q公司是不太好删除交易了,但是打包区块同样也变难了。总之世界上没有完美的方案,旧问题的解决总是伴随着新问题的产生。Q公司通过大量计算找出满足要求的区块哈希值,从而证明区块有效,这个过程叫做工作量证明(Proof of Work,简称PoW)。
还有一点,要求前面有几个零也是有讲究的,不能随便定。如果要求的零比较少,Q公司很快就能算出合格的哈希值,修改区块也就没啥难度了;如果要求的零比较多,Q公司可能很长时间都无法产生区块(打包交易),也就是说用户可能要等很久才能看到自己的交易被处理,导致体验很差。到底规定几个零比较合适暂时不影响本章的讨论,我们只要知道这个难度值是记录在区块里的就可以了,到下一章再继续聊这个问题。
交易确认
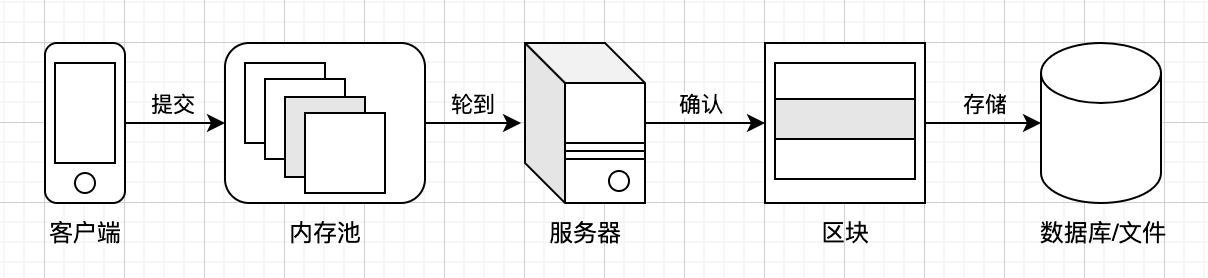
由于增加了PoW,Q公司每产生一个区块都是需要花一定时间的(例如十秒钟),这导致了几个问题。第一,Q公司无法实时处理交易了。它需要先收集用户交易,等攒够一定数量后(例如100个),把它们打包成区块,然后再计算哈希。第二,用户的交易在被Q公司打包进某个区块之前,都不能算数。交易被打包进块这个动作叫做确认(Confirmation)。
那么这些等待确认的交易待在哪儿呢?它们会在Q公司一台专门的服务器里排队,等候处理。这台服务器在内存中收集这些交易就行,通常也不需要持久存储(比如说写入数据库)。我们称未确认交易临时驻足的这片服务器内存为内存池(Memory Pool,简称Mempool)。而区块呢?可以继续存数据库,也可以直接以文件形式存到硬盘里,这个细节不重要,这里就不讨论了。一个交易的完整生命周期如下图所示:
万一某个空闲时间(比如凌晨),玩家特别少,导致一直没有足够的交易进入内存池咋办?那些已经在里面的交易岂不是得一直等待下去了?这个问题也好解决,Q公司每次只等少量时间(比如也是十秒钟),如果超过这个时间,哪怕只有一笔等候交易,也会把它打包成块。
我们可以把内存池想象成汽车站,把交易想象成等候乘车的乘客,把区块想象成定期驶来的汽车。乘客在车站有序候车,待汽车到站后上车出发;若等候的乘客较多,一辆车只能载走部分人,剩余乘客需继续排队;若乘客稀少,汽车到站后就能快速载上所有乘客启程。相比之下,之前的实时交易处理模式则好比乘坐出租车,乘客无需排队等候,基本可以“招手即停、随需随走”。
哈希锁链
有了PoW机制之后,Q公司打包每个区块必须耗费一定的时间,修改某个区块也是这样。对于单个的区块来说,这的确是增加了篡改的难度。但是这并没有从根本上解决问题,如果Q公司真想删掉一笔交易,无非也就是多花一点点时间而已。那么还有改进的空间吗?有。我们可以把前一个区块的哈希值也放到当前区块里,一起参与哈希运算,如下图所示:
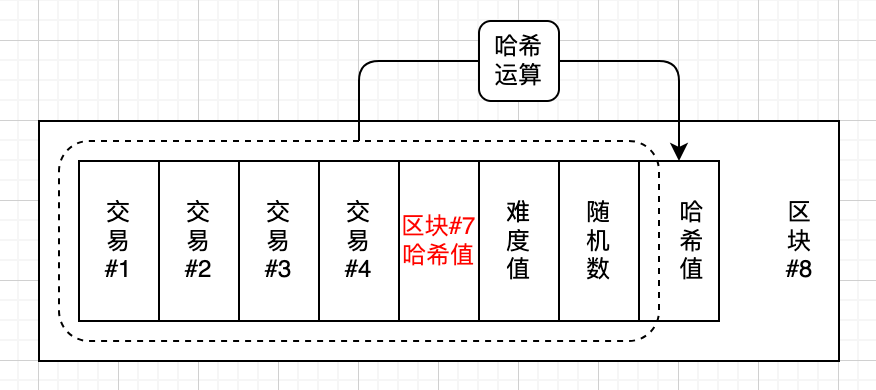
比如说下一个要产生的是区块#100,而Q公司想删掉区块#67里的某笔交易会发生什么?首先,Q公司修改区块#67,然后重新计算哈希值,这并没有太大难度。然而,由于区块#68里记录了区块#67的哈希值,这个改动导致这两个区块完全对不上号了。所以Q公司只能继续修改区块#68,重新计算它的哈希,然后去修改区块#69,以此类推,直到追上最新的块,把从#67开始的全部区块都修改一遍。
别忘了,在Q公司修改这些老区块的同时,新的区块也在源源不断地产生呢。所以这个难度就有点大了,而且区块越老,修改难度越大。对用户来说,如果你提交了一笔重要的交易(比如大额充值交易),最好是等包含它的区块后面跟了足够多的(比如六个)新区块以后,才认为交易(很大概率)不会被Q公司给删除掉了。由于我们仍然无法100%确定交易不会被删除,所以我们称其为概率确认机制。
从概念上来说,所有的区块通过哈希值形成了一条无形的锁链,而这个结构就叫做区块链(Blockchain),如下图所示:
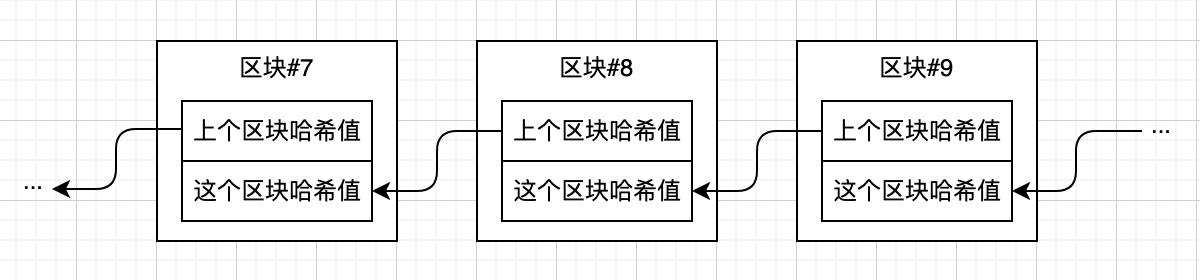
虽然我们通常都是横着来画区块链的,就像上图这样。但是也可以把区块链想象成一堆一个一个摞在一起的箱子,于是我们也称区块的ID为区块高度,称最高的那个区块的ID为整条区块链的高度。顺便说一下,我们通常称第一个区块为创世区块(Genesis Block)。
再强调一下,如果是比较重要的交易,一定要等待足够的确认后,才认为它不会被回滚,否则就会有问题。比如说某人向你支付一笔可观的Q币购买一个游戏装备,你最好等付款交易被确认一段时间(比如六个区块)后再发货。否则该交易有一定几率会失败(比如发生分叉,该交易所在的块不在最长链上),而这笔Q币就又可以去购买其他装备了。利用“重复花费同一笔资产”这一问题去侵犯别人利益的行为通常叫做双花攻击(Double Spend Attack)。
默克尔树
出于完整性考虑,还有一个细节需要交代一下。实际上在计算区块哈希时,并不是像前面画的那样,把所有的交易数据都拼接在一起。而是先算出一个整体的交易哈希值(1),然后再通过交易哈希值+上一个区块哈希值+随机数去算区块哈希值(2),大致如下图所示:
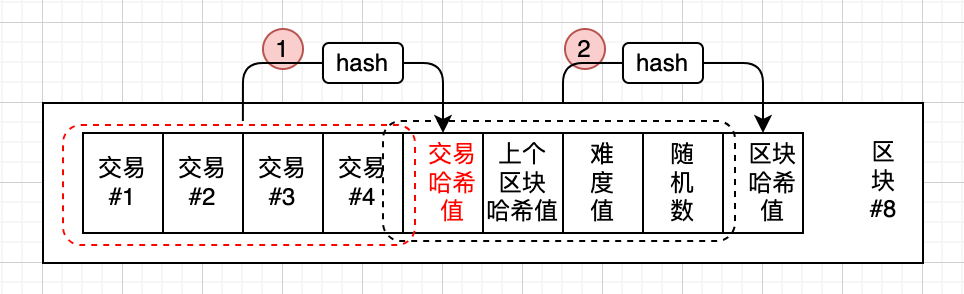
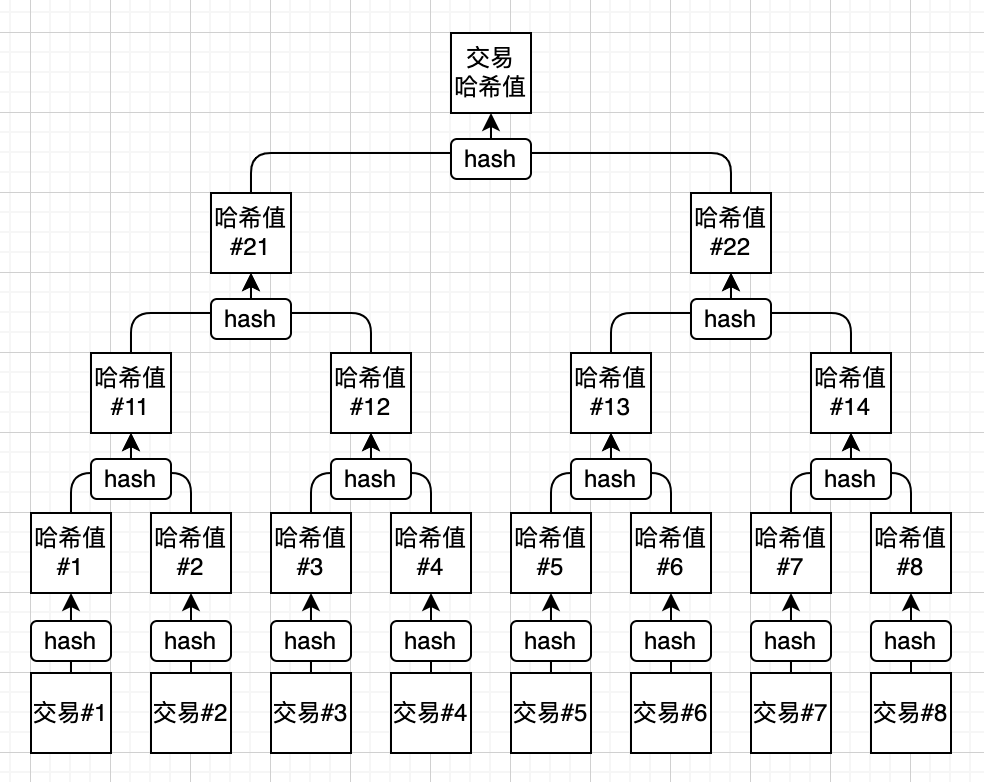
而交易哈希值也不是像上图这样简单去计算,而是用一种叫做默克尔树(Merkle Tree)的方式,一层一层的去算好多次哈希值,最后得到一个根哈希值(Root Hash)。那为什么要用这么麻烦的方式去算交易哈希值呢?肯定是有很大好处的,例如我们可以证明某笔交易存在于某个区块内。不过这些细节并不影响整体的讨论,所以这里就不仔细介绍了,感兴趣的读者可以通过搜索引擎或者AI聊天机器人去查找相关资料。默克尔树的生成方式如下图所示(在计算机科学里,树通常倒着画,树根朝上):
本章小结
为了证明自己不会随意删除用户的交易,Q公司把交易记录表替换成了区块链技术。一定数量的交易被打包成区块,然后通过哈希锁链连在一起成为区块链。这个变化不仅体现在交易的数据格式和存储方式上,更体现在交易的处理方式上。由于PoW机制的引入,用户的交易由实时处理变成了延迟确认。但改造效果也是实打实的,虽然用户在交易体验上打了一些折扣,但完全不用担心自己的交易会被Q公司随意删除了。
不过目前还是有几个问题没有解决。第一,Q公司如果违反承诺,利用规则漏洞随意增发Q币怎么办?第二,Q公司如果拒绝接收某用户的交易怎么办?第三,Q公司是怎么处理内存池里的等候交易的,是按到达的先后顺序?金额大小?还是其他规则?如果某笔交易一直在内存池里排队但得不到处理怎么办?这些问题我们会在下一章讨论。